Quando i siti bloccano gli agenti AI: la nuova guerra ai bot
Cloudflare, OpenAI e JPMorgan mostrano come il web stia separando ricerca, training e agenti AI. La nuova battaglia riguarda accessi, pubblicità e responsabilità.
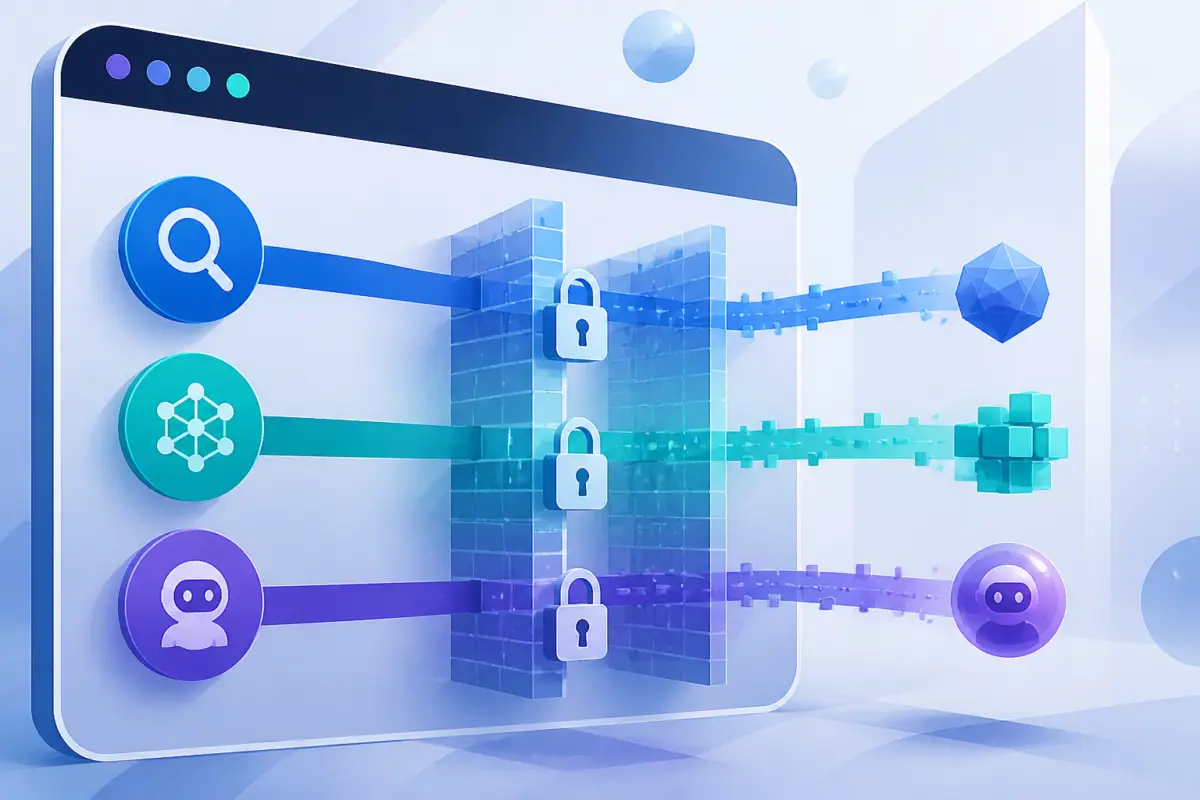
I siti web stanno entrando in una fase nuova: non bloccano più soltanto i bot, ma distinguono in modo esplicito tra ricerca, addestramento e agenti AI. È il segno di una guerra meno rumorosa di altre, ma più politica e commerciale: non si decide solo chi entra nel web, ma quale automazione può entrare, cosa può fare e a quali condizioni.
Il caso più chiaro arriva da Cloudflare, che ha formalizzato controlli separati per Search, Training e Agent. Per i nuovi domini, dal 15 settembre 2026, i default sono diventati più restrittivi sulle pagine con annunci: Training e Agent vengono bloccati, mentre Search resta consentito. La scelta riflette un problema concreto: molti bot e crawler oggi non fanno una sola cosa, ma mescolano ricerca, raccolta dati per l’addestramento e uso da parte di assistenti o agenti.
Perché il web sta cambiando le regole per gli agenti AI
La questione non è soltanto tecnica. Quando un agente AI visita un sito, può limitarsi a leggere, ma può anche navigare, compilare form, cercare prodotti o tentare un acquisto. Per un editore o un gestore di piattaforma, queste attività hanno effetti diversi. Un crawler di ricerca può portare traffico; un sistema di training può estrarre contenuti senza restituire visite; un agente può aggirare parte del percorso tradizionale dell’utente e interferire con pubblicità, paywall e controlli antiabuso.
Cloudflare ha spiegato proprio questa necessità di separare i flussi, per evitare che i cosiddetti mixed-use crawlers vengano trattati come un blocco unico. In pratica, il punto non è vietare “l’AI” in astratto, ma gestire in modo diverso richieste che hanno finalità distinte. È una logica che sposta il web verso un modello più selettivo: accesso sì, ma solo se il comportamento del bot è identificabile e accettabile per il proprietario del sito.
Il lato economico: pubblicità, accessi e margini
La dimensione economica è evidente nelle scelte dei siti che vivono di pubblicità o di abbonamenti. Se un agente legge contenuti per conto di un utente, oppure li usa per decidere azioni successive, il sito non controlla più soltanto il numero di visite, ma anche la qualità del traffico e il valore dell’intermediazione. Da qui la volontà di distinguere tra traffico umano, ricerca, addestramento e agenti: ogni categoria produce conseguenze diverse su ricavi, visibilità e accesso ai contenuti.
Questa frizione spiega perché alcuni operatori stiano adottando regole più rigide proprio sulle pagine monetizzate. La linea di fondo è semplice: se i contenuti finanziano servizi e giornalismo tramite inserzioni, il sito vuole decidere se l’uso da parte di una macchina equivalga a un accesso “lecito”, a una semplice lettura tecnica oppure a un consumo che sottrae valore commerciale senza compensazione.
OpenAI avverte: anche i bot verificati possono essere fermati
Il problema non riguarda solo chi blocca, ma anche chi prova a farsi riconoscere come traffico legittimo. OpenAI ha avvertito che perfino crawler e agenti verificati possono essere interrotti da CAPTCHA, browser challenge, WAF e regole geografiche. In altre parole, un bot può essere autorizzato dal fornitore o riconosciuto come legittimo, ma restare comunque ostacolato dalla difesa del sito.
Le indicazioni ufficiali suggeriscono di controllare allowlist, robots.txt e i sistemi di verifica bot del provider. Questo conferma che la guerra ai bot non si gioca solo sul diritto di accesso, ma anche sull’infrastruttura: un agente può essere tecnicamente “buono”, e tuttavia risultare bloccato da sistemi di sicurezza progettati per fermare traffico anomalo o automatizzato.
Il caso JPMorgan: quando il rischio diventa bancario
Il fronte più delicato è quello finanziario. Nel call sugli utili del terzo trimestre 2026, il CFO di JPMorgan Chase, Jeremy Barnum, ha detto che alcuni servizi di agenti usano credential sharing e screen scraping per muovere denaro, pratiche che la banca considera insicure e che cerca di bloccare. Barnum ha aggiunto che, se un cliente consegna a un agente le proprie credenziali, le conseguenze delle azioni compiute da quell’agente possono ricadere sul cliente stesso.
Qui il tema cambia scala: non si parla più solo di accesso ai contenuti, ma di operazioni eseguite con credenziali personali. La banca mette in chiaro un principio che può diventare centrale anche per altre piattaforme: delegare a un agente non significa scaricare su di lui la responsabilità finale. Se l’accesso avviene con credenziali condivise, il rischio operativo e quello contrattuale restano agganciati all’utente.
Una guerra di regole, non solo di tecnologia
Il quadro che emerge è quello di una nuova frontiera dell’accesso al web. I siti non stanno semplicemente reagendo a una pioggia di bot: stanno costruendo barriere più sofisticate per distinguere tra usi diversi dell’automazione. Le piattaforme AI, dal canto loro, spingono per far passare agenti utili e verificabili, ma devono farlo dentro limiti che i proprietari dei siti considerano compatibili con sicurezza, responsabilità e ricavi.
In questo senso la “guerra ai bot” non è un conflitto lineare tra siti e intelligenza artificiale. È piuttosto una trattativa sul potere di definire chi entra nel web, con quali credenziali e per fare cosa. E la risposta, almeno per ora, è sempre più spesso la stessa: non tutti i bot sono uguali, e non tutti gli agenti meritano la stessa porta d’ingresso.
Fonti
- https://www.jpmorganchase.com/content/dam/jpmc/jpmorgan-chase-and-co/investor-relations/documents/quarterly-earnings/2026/3rd-quarter/3q26-earnings-transcript.pdf
- https://www.cloudflare.com/press/press-releases/2026/cloudflare-allows-the-agentic-internet-to-flourish-with-a-simple-philosophy-your-content-your-rules/
- https://blog.cloudflare.com/content-independence-day-ai-options/?utm_campaign=article-redirect&utm_content=cloudflare-ai-blog&utm_medium=referral&utm_source=shipfeed
- https://help.openai.com/en/articles/20001243-advertiser-guidance-for-allowing-openai-web-crawlers
- https://developers.openai.com/api/docs/bots?wvideo=akzb57a5z3
- https://blog.cloudflare.com/bot-preference-sync